
一度の改善が、次の改善を見つける力まで高めるとしたら?
有効な編集を見つける力が高まれば、モデルは次の改善も手伝えるかもしれない。この再帰的自己改善の循環を、実験で確かめたい。その具体的な出発点が、AstraによるQwenの編集だ。そこには、モデルの状態に応じて押す強さが変わる、ステアリングの規則が重みに書き込まれていた。
Weight-Space Programmingの研究でAstraが書き換えたのは、二つのMLP行列の一部の列だった。Takehiらの報告では、MATH-500の正答率が7.9%から48.1%へ上がり、トークン上限に達した回答の割合は93.0%から33.1%へ下がった。勾配を使った学習は許されていなかった。この成績は原著者らの結果であり、私たちの実験は、公開された編集の仕組みを調べたものである。1
本稿の貢献は、Astraが書いた規則、共有重みで実現できる補正、Fisher幾何が局所的に予測する出力の変化を結び付けた点にある。 編集を活性化へのステアリングとして再構成し、幾何による予測がどこまで通用するかを測る。土台の代数は既知だが、この公開編集に適用すると、次に検証すべき問いが具体的になる。
エンジニアに提案したい手順は明快だ。まず活性化への介入として補正を試す。編集を許された重みで、異なる入力への補正を実現できるかを調べ、それから編集したモデルを評価する。幾何は、実現できる補正を記述し、出力分布の小さな変化を共通の物差しで測る。今回の編集方向では、Fisherは小さな変化をよく予測したが、元の編集強度では精度が落ちた。より良い編集を選ぶ道具として役立つかは、次に実験で確かめたい。
そもそも修正の手がかりは、最後まで答えられなかった85件の回答だった。
AstraがQwen3.5-0.8Bに96問の練習問題を解かせると、正解は11問。残る85問は、32,768トークンを使い切っても答えにたどり着かなかった。出力の末尾には、同じ表現が何度も並んでいた。幾何学的な計量を調べるまでもなく、Astraには、修正の糸口になりそうな失敗のパターンが見えていた。3
LLMは、数億個ものパラメータの中から、どうやって編集すべき箇所と方向を見つけたのだろうか。
学習済みネットワークには、内部の特徴を観測し、その働きを変えられる箇所がある。活性化を測り、それを残差ストリーム(各層が情報を読み書きする表現)へ書き込む行列を変更して、出力を確かめられる。Astraはこの構造を利用し、層ごとに異なる方向へ作用する、小さな編集を見つけた。書き込まれた規則は、その時点の活性化を読み、それに応じて補正の強さを変える。
以下では、Astraが見つけた失敗、重みに書き込んだプログラム、その作用を記述する幾何を順に見ていく。そのうえで、モデルを越えて繰り返し使える手法へ育てられるか、そして一度の編集の成功が、次の編集を作る力まで高めるかを考える。
実験の一覧と範囲
結果の出所と範囲。 ベンチマークの大幅な改善は原著者らの報告である。私たちが行ったのは、40個のprefixでの編集の再構成、32個のprefixでの局所KLの測定、人工的な反復テキストを用いたステアリングの対照実験である。prefixとは、モデルに与える先行トークン列を指す。小規模な生成の予備実験も完了しているが、MATH-500全体での再現と、固定プログラムによる探索の検証は未完了である。絵画は仕組みを伝えるための寓意であり、数理的な曲面は明示的に定義したモデルに基づく。
Astraは、個々の重みの意味をすべて理解する必要はなかった。観測できる失敗を見つけ、短い規則を実行できる線形写像に介入した。規則は、現在の活性化から係数を読み取り、決まった方向へ補正を加える、というものだ。まず、その補正を一つの共有行列で実現できるかを調べる。次に、出力分布をどれだけ変えるかを比べる。前者には実現可能な部分空間、後者には計量という道具を使う。
説明の役割も分けておきたい。ログからは、Astraが失敗を見つけて編集を選ぶ過程を追える。代数は、見つかった編集がどう実行されるかを説明する。Fisher幾何は出力の局所的な変化を測り、共有重みの制約と合わせて次の編集を考える道具になる。ただし、なぜAstraがこの方向、層、ゲインを選べたのかを、Fisher計算で説明するものではない。
1. Astraには、何が見えていたのか?英語原文 ↗
まず、Astraが何を使って、どのような問題に取り組んだのかを確認しよう。初期プロンプトには、Qwenのアーキテクチャ、重みを読み書きする関数、正解付きの練習問題、出力や活性化を収集するツールが示されていた。修正すべき失敗の例として、同じ表現の繰り返しも挙げられていた。Astraに求められたのは、失敗を分類し、相関の観察にとどまらず実際に介入し、その強さを変え、まだ使っていない問題で効果を確かめることだった。2
評価ツールを50回呼び出せる実行では、この観測と介入を繰り返すことができた。「50」は評価ツールの呼び出し回数であり、モデルの順伝播の回数ではない。1回の呼び出しで数百件を生成することも、teacher forcingでテキストを評価することもあった。後者では、モデル自身に次のトークンを選ばせず、与えた系列を順に読ませて各位置の予測を調べる。Astraは、練習問題への出力を調べ、内部の量を測り、候補となる編集を施し、探索に使っていない問題での挙動を見て次の候補を決めていた。
ログには、最終編集に至るまでの失敗したリクエストや、判断の難しい初期結果も残っている。単一ニューロンを無効化するアブレーションと、その後に試した単一層での方向成分の除去は、32問に対してそれぞれ+6.25パーセントポイントの変化を示した。ただし、いずれもばらつきの大きい結果だった。後に層15と19を同時に編集すると、探索に使っていない問題でも、はるかに大きな改善が得られた。診断から編集へは、こうした試行錯誤を経て到達したのである。
この探索を可能にした条件は三つある。第一に、失敗が出力にはっきり表れていた。多くの回答で、長い反復の末に上限で打ち切られるという共通のパターンが見られた。第二に、活性化と対数確率を測れたため、反復するテキストとそうでないテキストを定量的に比較できた。第三に、MLPのダウンプロジェクションには、線形な書き込み経路があった。この構造が、短いプログラムによる修正を可能にした。ただし、成功のどこまでがAstraの推論によるものか、プロンプトやツール、対処しやすい失敗の構造にどれだけ助けられたかは、この結果だけでは切り分けられない。
10回、25回という、より少ない呼び出し回数での実行も重要である。どちらも大まかには同じ失敗を捉えたが、得られた編集の効果は弱かった。10回の実行では、多数の出力行列に比較的弱いランク1型の操作を加え、25回の実行ではアテンションヘッドを無効化した。同じ診断に至っても、同じ解が見つかるとは限らない。成功の理由を考えるには、こうした近い試みで効果が伸びなかったことも説明する必要がある。
公開ログの3つの実行を並べると、次のようになる。すべて原著の報告であり、私たちの再実行ではない。
| 報告された実行 | 探索に使える評価回数 | 公開概要に記載された編集 | 報告されたMATH-500正答率 |
|---|---|---|---|
| p10c | 10回の評価API呼び出し | 層8–22にわたる30行列からループ方向を1つ除去、ゲイン1.5 | 12.3% |
| p25c | 25回の評価API呼び出し | 層15のヘッド7を無効化 | 14.1% |
| p50c | 50回の評価API呼び出し | 層15および19のMLPで、各層64列を選び、指定方向の成分を減算、ゲイン6 | 48.1% |
この表が示すのは、それぞれの実行でエージェントが実際に作ったプログラムの違いである。探索に使える回数はリソース量であって、それだけで正答率の差を因果的に説明することはできない。原著のREADMEには、未編集モデルの正答率7.9%と、打ち切り率の変化も記載されている。48.1%という値を含め、ここでは原著の結果を紹介しており、独立した完全再現を報告しているわけではない。1
この結果から「Astraが重み編集によって数学能力を獲得させた」と結論するのも早い。評価課題は数学だったが、観測された障害は、回答を最後まで書き終えられないことだった。原著の確認用セットでは、以前はトークンを使い切っていた多くの回答が、編集後には解答に到達した。編集後に正解した回答は、単に早く終了したのではなく、むしろ長くなっていた。この傾向は、もともとの能力が答えに結びつくのを妨げていた反復を取り除いた、という説明と整合する。低ランクの介入によって、一般的な算術・代数の能力が新たに加わったことを示す証拠ではない。
この違いは評価にも反映させる必要がある。正答率だけを一つの能力スコアと見るのではなく、編集で救われた回答、逆に失われた正解、完了したものの誤っていた回答、回答の長さ、空白を繰り返す異常な出力を分けて数えるべきである。
実務上の教訓は、編集方法を選ぶ前に、まず失敗を測定できるようにすることだ。全体のスコアが低くても、複数の失敗に共通する内部状態があるのか、必要な特徴が欠けているのか、デコーディングに起因するのか、無関係な誤りが混在しているのかは分からない。85/96という観測は、幾何学的な解釈に進む前に、探索の範囲を絞る手がかりになっていた。
2. 0.016%の編集は、どのようにプログラムとして働くのか?英語原文 ↗
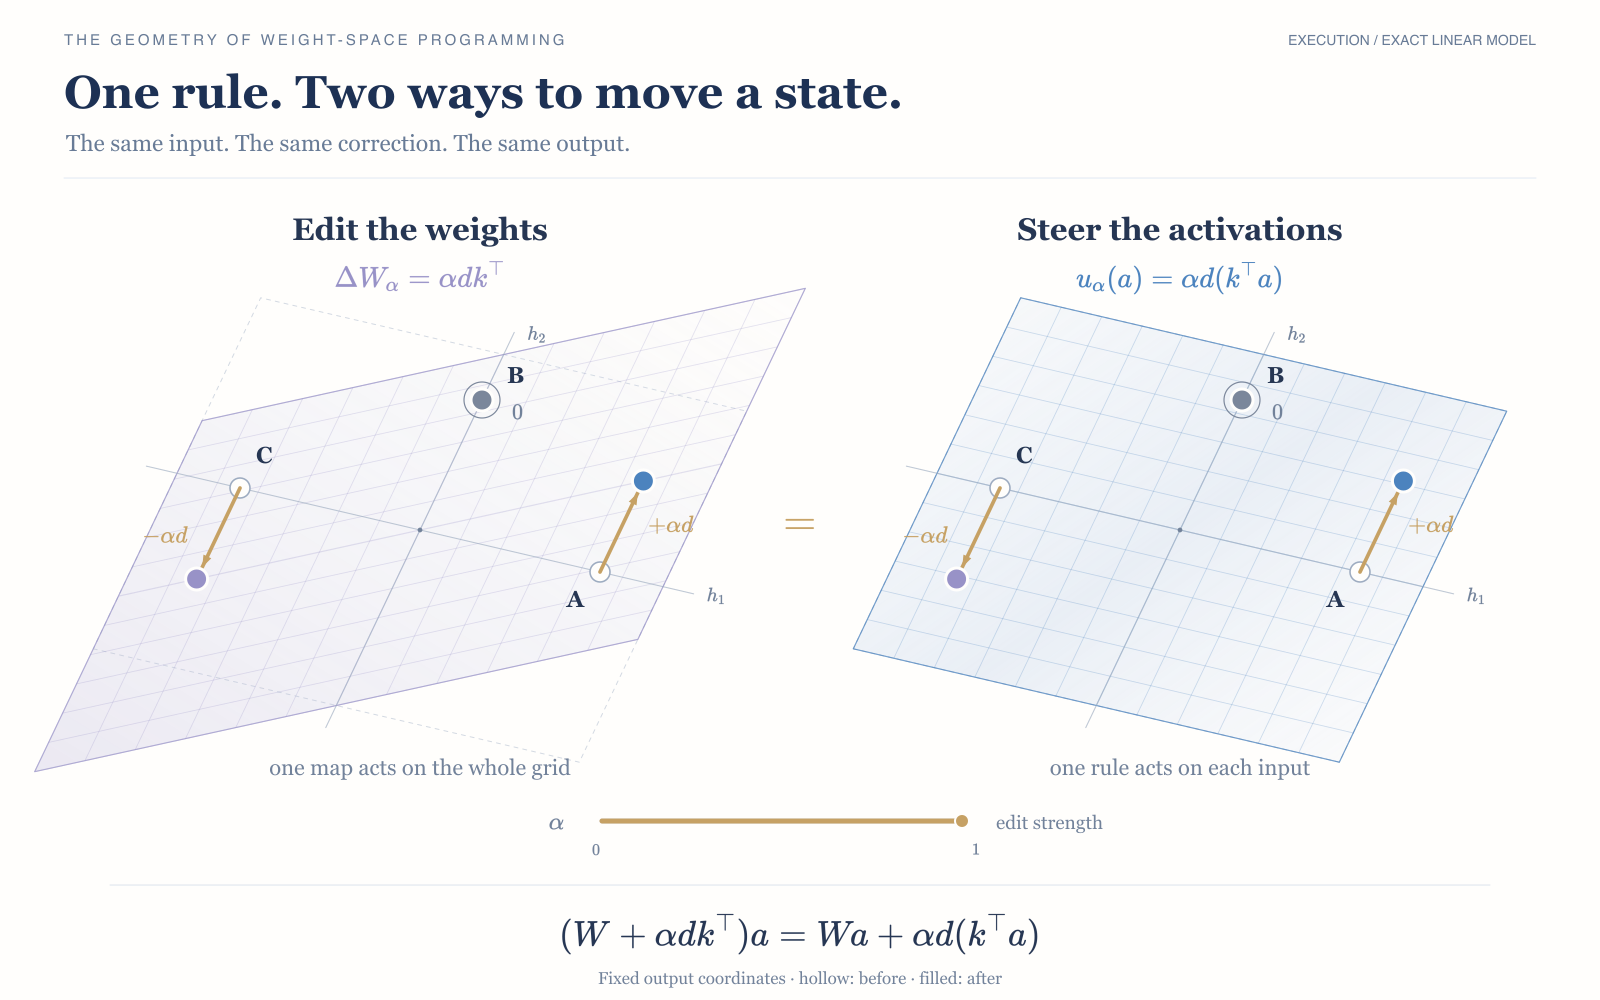
一つの共有行列が、入力ごとに異なる補正を加える。線形な射影では、重み編集と活性化への介入で同じ規則を厳密に実行できる。図はその数学的な例である。
大きく表示 ↗
一つの編集済み行列は、異なる入力を異なる量だけ、場合によっては逆向きに動かせる。図は、その同じ規則が二通りに実行される様子を示す。左では重みに保存され、右では活性化に適用される。対応する出力は一致する。
線形な例の読み方
この図では、厳密に定義した単純なモデルを使って、二つの操作の対応を示している。Qwenの活性化を記録した図ではない。状態をA=(1,0)、B=(0,1)、C=(-1,0)とし、W=I、k=(1,0)、d=(0,.7)と置く。左では、一つの編集済み行列が入力の格子全体を変換する。右では、同じ補正を各活性化に個別に加える。どちらも固定した出力側の座標軸で描き、白抜きの点が元の出力、塗りつぶした点が編集後の出力を示す。元の編集強度では、Aは+d、Bはその場にとどまり、Cは−dだけ動く。
アニメーションでは、左右の介入を同じ強さで徐々に強める。対応する点は、その間ずっと一致する。これは代数的な恒等式を示すものであり、Astraの探索やQwenで測定した動力学を示すものではない。Aを一度だけ外部から押しても、それだけで後続の入力に対する方策を定めることはできない。
「0.016%」はパラメータ数の比率を概算した値である。対象にした131,072個のエントリ(2×64×1024)を、モデル全体のおよそ8億パラメータと比較している。重みノルムに対する比率でも、二つのMLP全体に占める割合でもない。
実際の最終編集が作用したのは、層15と19のMLPダウンプロジェクションだった。行列がMLPニューロンの活性化を残差ストリームへ写すとしよう。編集の仕組みは、次の厳密な恒等式で表せる。 現在の状態からスカラーを読み取り、方向ベクトルに掛けて、その分だけ活性化を動かす。このスカラーは正にも負にもなり、連続的に変化する。「ゲート」と呼んでも、ループの有無だけを判定する二値の検出器とは限らない。Astraによる各層の編集を理想化すると、次の形になる。
ここでは単位方向ベクトル、は編集する列を選ぶマスク、は介入の強さを決めるゲインである。変更後の行列を適用すると、活性化の変化は
となる。ベクトルが動かす方向を決め、それに掛かるスカラーが、現在のMLP活性化に応じていつ、どれだけ動かすかを決める。つまり、重みに保存されているのは、常に同じベクトルを加える操作ではなく、状態に応じて作用が変わるステアリングの規則である。
線形な書き込み箇所で考えると、介入の選択肢を次のように整理できる。
- 定数ベクトルを加える。編集可能なバイアスでも実現できる:
- スカラーを一つ読み取り、その値に応じて方向ベクトルを加える:
- ニューロンごとに出力ベクトルを指定する:
- 入力ごとに任意の変化を指定する:
これは線形な箇所にどのような介入ができるかの分類であり、KLを最小にする方法を述べたものではない。例えば、あらゆる入力に同じ非ゼロの変位を加えたい場合、バイアスのない行列だけで常に実現できるとは限らない。バイアスも編集できれば、その操作は可能になる。最後の「入力ごとに任意の変化を指定する」操作も、一般には一つの共有行列では実現できない。実現できる変化の範囲は、ヤコビアンの像に制約される。
実際の編集では、二つの層にそれぞれ異なる方向を使い、各層で64列を選んでいる。公開された式は、列をマスクした後も、bfloat16への丸め前ならランク1である。ただし、保存された重みの差分には、小さな丸め残差が含まれる。原著で評価されたのは保存済みの重みであり、仕組みを考えるための理想式とは、この点を区別する必要がある。
私たちのE1実験では、固定したprefix上で、保存された重み編集と、それと等価な加法的介入を比較した。FP32では40個のprefixに対し、最大ロジット差は、最大KLはだった。bfloat16では差が大きくなり、最大ロジット差は0.3047、最大KLは0.00713となった。これは、編集を加法的介入として再構成できることを調べた数値的な結果であり、新たな課題での性能評価ではない。
ゲインの値にも注意したい。ゲイン1なら、選んだ列から方向の成分を取り除く。ところがゲイン6では、その成分は元の値のおよそ−5倍になる。成分を消すだけでなく、向きを反転させる操作だ。選んだニューロンが対比から得た方向へ書き込むと、編集はその逆向きの寄与を加える。「アブレーション」とだけ呼ぶと、このフィードバックに似た働きが見えなくなる。ただし、このゲートが自然に生じるすべての反復ループを選択的に検出する、と確認されたわけではない。
複数の層を編集する場合は、各層で読み取る活性化にも注意が必要になる。層19に届く入力は、すでに層15の編集の影響を受けている。編集後の実行中に得られるを使えば、加法的な恒等式はそのまま成り立つ。一方、未編集モデルであらかじめ記録したゲートの値を再生しても、編集後のモデルを厳密には再現できない。ここでいう「スイッチ」は固定した係数列ではなく、その都度の活性化から値を計算する仕組みなのである。
重み編集と活性化フックが一致する条件
一つの線形な書き込み箇所を考え、各サンプルのニューロン活性化を行として並べる。
# W: [residual_dim, neuron_dim]; u: unit direction
readout = mask * (u @ W)
D = -gain * u[:, None] * readout[None, :]
edited_write = a @ (W + D).T
hooked_write = a @ W.T + a @ D.T
丸め誤差のない算術では、二つの計算結果は一致する。公開モデルを再構成するときは、理想式ではなく、丸め残差を含む実際の保存差分を使う。後段の編集層では、先行する介入を反映した活性化を使わなければならない。
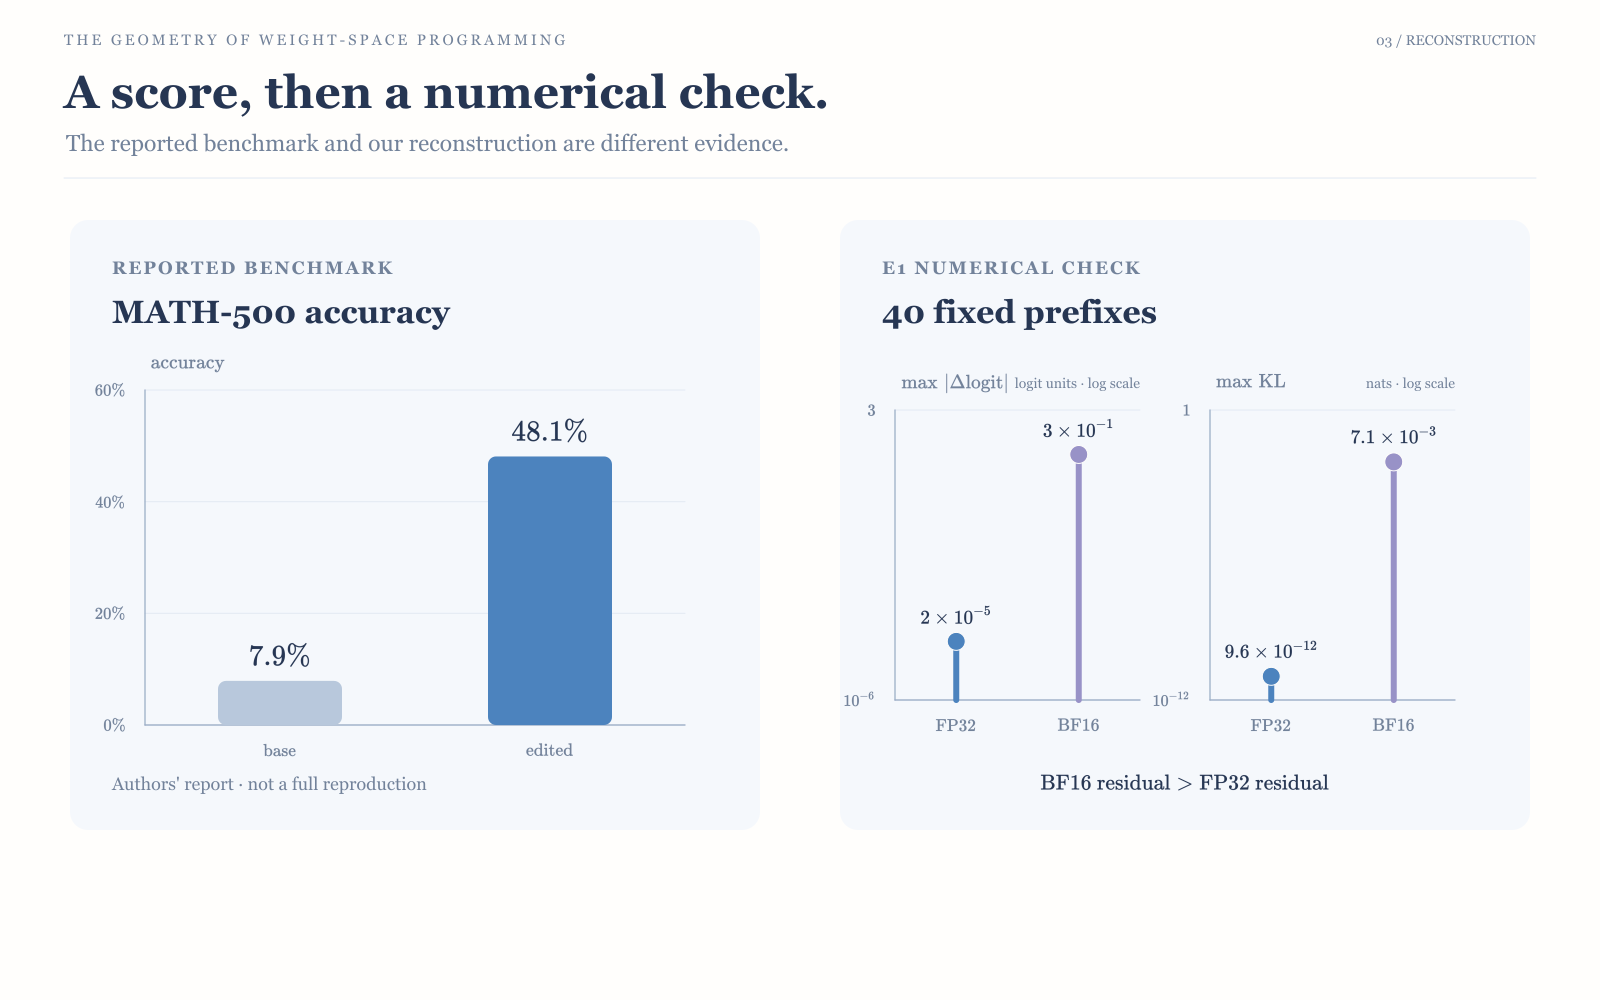
左は原著が報告した成績の改善。右のE1は、40個の固定prefixで重み編集と活性化への介入の数値的一致を調べた実験であり、ベンチマーク全体の再現ではない。
大きく表示 ↗設定・適用範囲・元ファイル
これとは別に、小規模な生成の予備実験も行った。選んだ8問について、未編集モデルでは各問1サンプル、編集後のモデルでは各問4サンプルを生成した。正解はそれぞれ0/8と8/32、上限による打ち切りは8/8と18/32だった。この予備実験では、生成処理が動くことを確認し、実行時間を測った。サンプル数が条件間で異なるため、条件を揃えたベンチマーク全体の評価値としては扱えない。4
係数 を変えると、矢印 の大きさが変わる。負の値では向きが反転する。ゲートの符号が、介入の向きを決める
3. 状態に応じて変わるスイッチは、本当に必要だったのか?英語原文 ↗
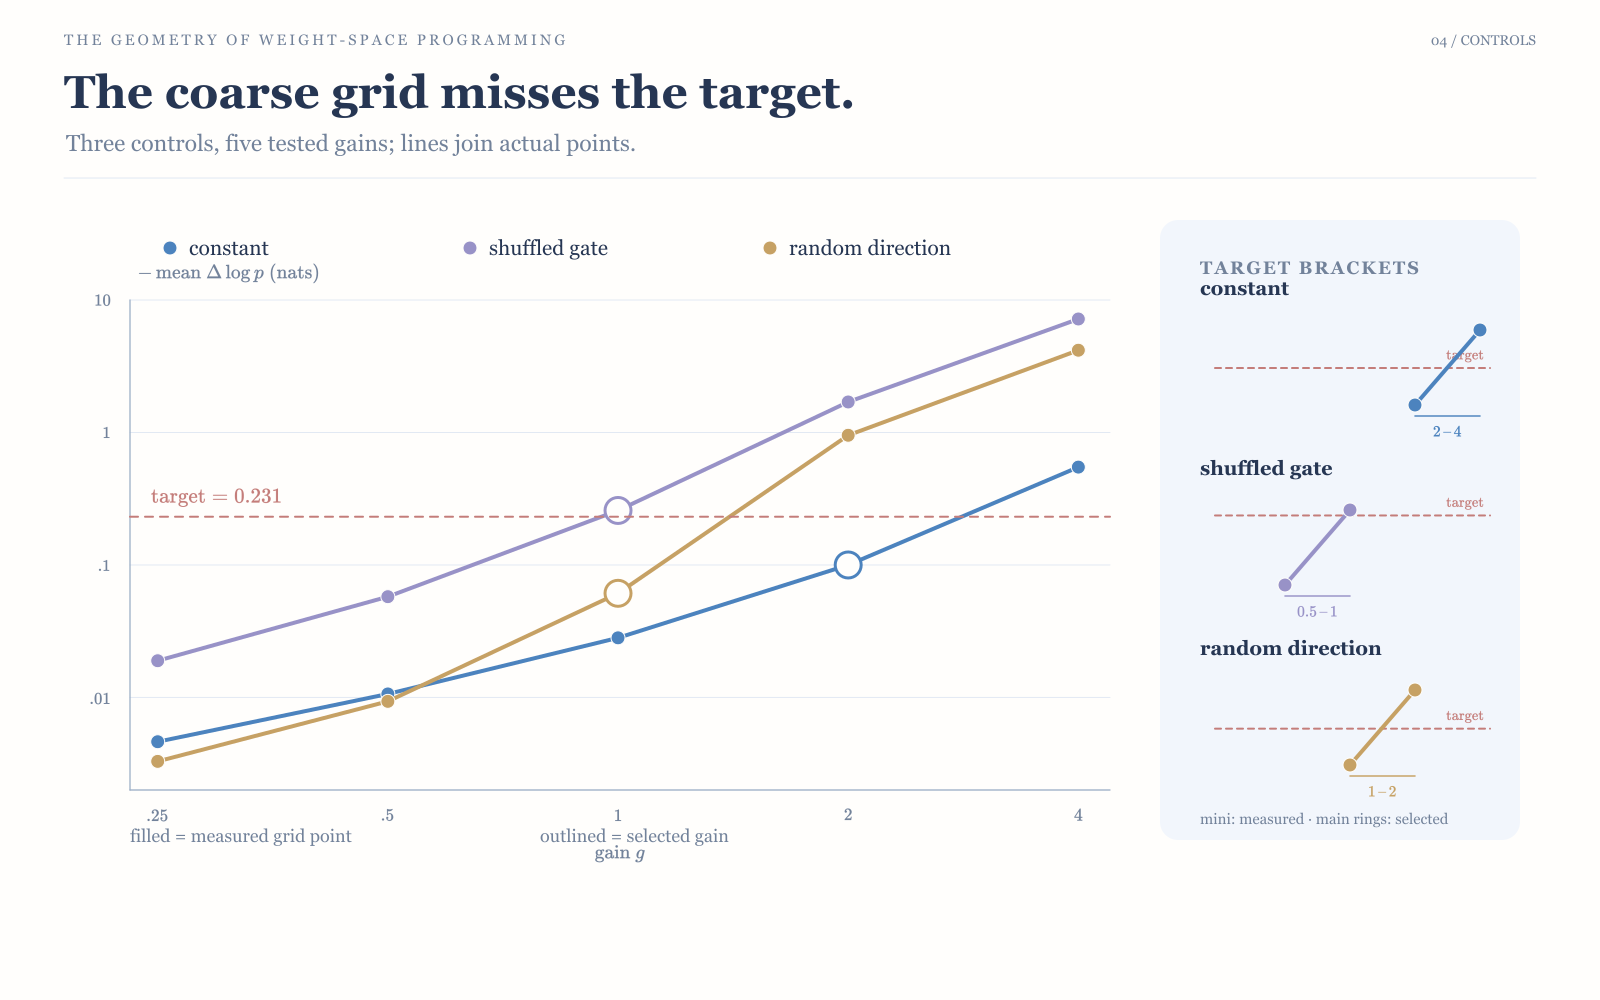
三つの対照条件とも目標効果をまたぐが、選んだゲインでは一致していない。人工的な系列を与えたこの比較では効果を揃えられず、ゲートが必要かどうかは判断できない。
大きく表示 ↗設定・適用範囲・元ファイル
仕組みの必要性を確かめるには、状態に応じたスイッチを、方向への一定の介入に置き換えてみるとよい。反復テキストへの効果を同じに揃えたとき、有用な出力につながるテキストをどちらがよく保てるだろうか。事前に登録したE2は、Astraのゲートをそのまま使う条件、定数介入、ゲートの値を入れ替える条件、ランダムな対照条件を比較する設計だった。ただし、今回の測定から言えることには二つの制約がある。
一つ目は、反復を人工的に作っていることだ。現在のE2の実験記録には、モデルが生成した反復ではなく、人工的に構成した続きのテキストをteacher forcingで与える実験だと明記されている。較正用に16件、評価用に32件を使い、参照回答のprefixの末尾16トークンを繰り返して反復テキストを作った。Qwenが実際の生成中にループへ陥った過程ではない。この実験は、構成した状態に編集がどう応答するかを調べるものであり、Astraが見つけた生成時の失敗を直接再現したものではない。
二つ目は、比較の前提となる効果の一致を達成できなかったことだ。定数、シャッフル、ランダムの各条件は、いずれも事前に定めた効果マッチングの検査に通らなかった。較正時の目標効果からの残差は、定数条件で+0.1312、シャッフル条件で−0.0266、ランダム条件で+0.1701だった。試したゲインの範囲と刻みでは効果を揃えられていない以上、「同じ効果を保ちながら副作用を減らせる」とは比較できない。
それでも、応答の違いを調べる資料にはなる。元のゲートと各対照条件では応答パターンが異なり、有用な出力につながる系列と反復系列について、teacher forcingで与えた各位置での応答を比較できる。ただし、ここから、サーモスタットのように状態に応じて働く制御が自然な生成にも必須だ、と結論することはできない。
記録された較正曲線では、3つの条件とも目標効果をまたいでいるため、ゲインを細かく探せば一致を改善できる可能性はある。次に必要なのは、同じ対照条件を保ちながら探索の刻みを細かくし、モデルが実際に生成した練習問題の回答から対比ペアを作ることだ。較正用と評価用のデータを分け、効果が揃ったことを比較の前提として確認する。そのうえで、人工的な続きの対数確率だけでなく、生成中にループへ入る確率や、そこから抜け出す確率がどう変わるかを調べる必要がある。
4. Fisher幾何でどこまで予測できるのか?英語原文 ↗
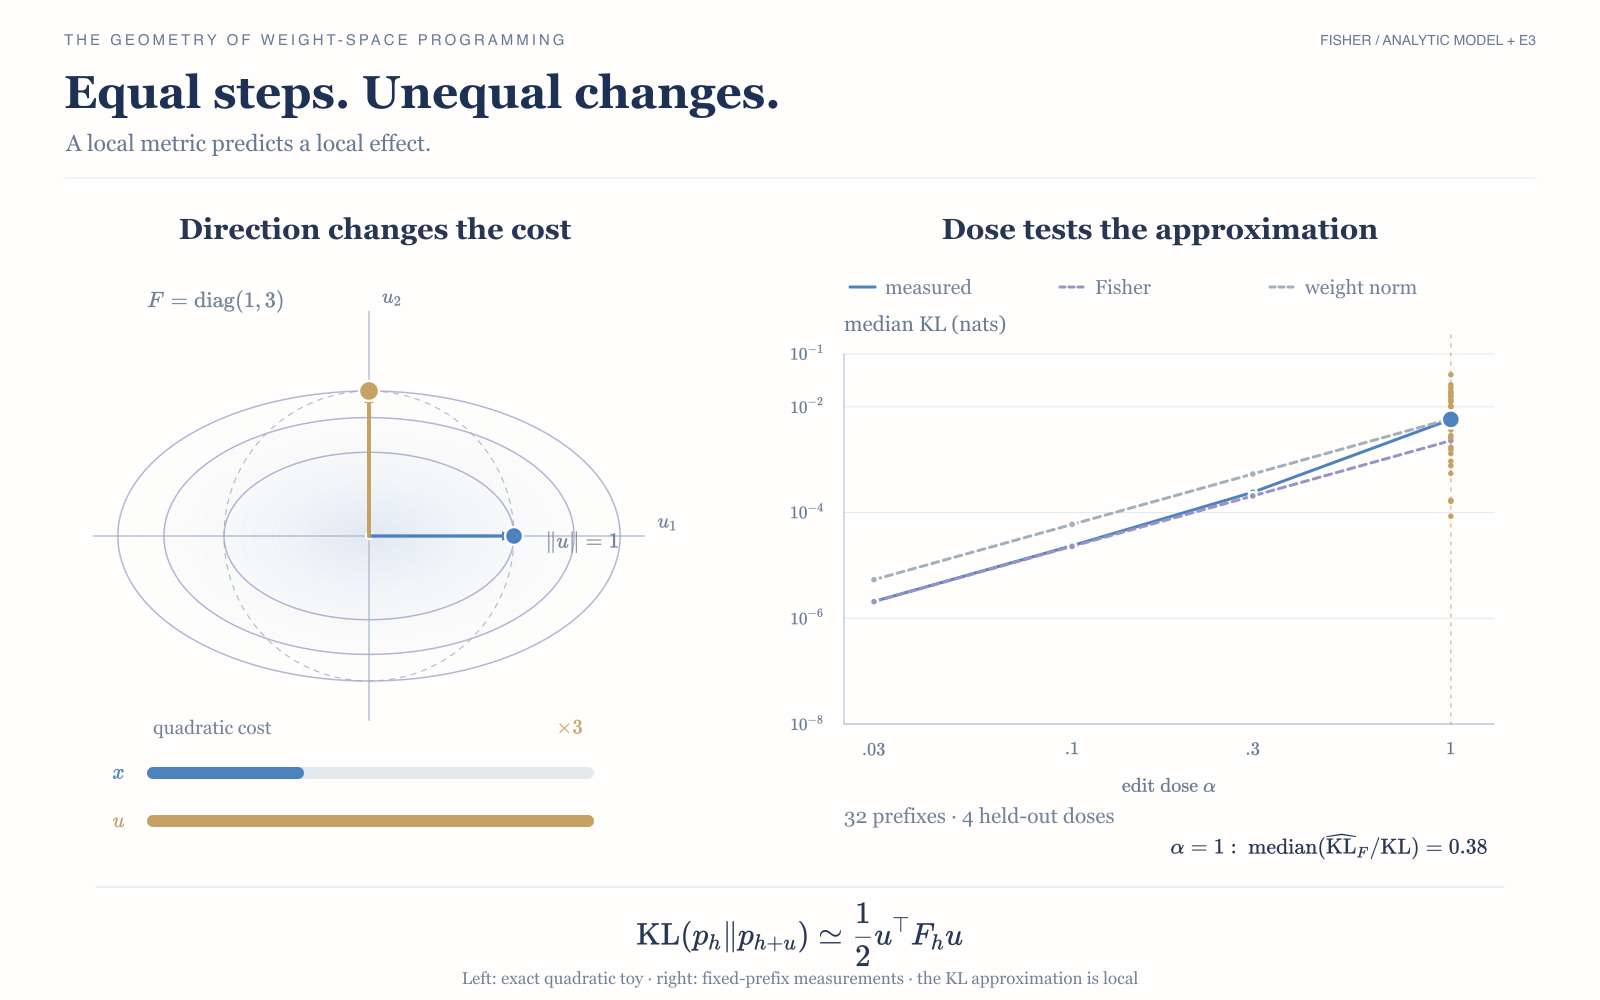
同じ長さだけ動かしても、局所的なコストは方向で変わる(左の数学例)。E3の測定(右)では、Fisherは小さな介入でのKLをよく予測するが、原著の編集強度では精度が落ちる。
大きく表示 ↗
重みの座標値から計算するノルムだけでは、モデルへの影響を捉えにくい。同じ大きさの重み変化でも、出力分布は大きく変わることも、ほとんど変わらないこともある。prefixを固定し、活性化を小さくだけ動かした場合、次トークンの分布のKLは局所的に
と表せる。ここでは、出力分布のFisher行列を活性化の座標へ引き戻したものである。この物差しが測るのは、二つの分布をどれほど識別できるかであって、回答の正しさや意味が保たれたかどうかではない。KLが小さくても、測っていない能力を損なう可能性はある。有用な出力につながるテキストでKLを小さく抑えることは、私たちが設計上選ぶ目的であり、Fisher幾何が自動的に保証する性質ではない。
E3では、この局所予測を32個の評価用prefixで検証した。Fisherは各prefixについて有限差分で推定し、ノルムに基づく比較手法の比例係数は、別の16個の較正用prefixで決めた。予測を評価する編集強度0.03、0.1、0.3、1.0は、局所的な当てはめには使っていない。
編集強度0.03では、対数スケールでの予測誤差の絶対値の中央値は、Fisherで0.013桁、重みノルムによる比較手法で0.479だった。一方、編集強度1では、それぞれ0.462と0.420となった。この指標で見ると、弱い介入ではFisherのほうが大幅に正確だが、元の編集強度ではわずかに劣る。
元の編集強度で、各prefixのFisher予測値を実測KLで割った比の中央値は約0.38だった。これは、prefixごとに計算した比の中央値であり、予測値と実測値の中央値を割った値ではない。また、導関数の推定や確認に用いた小さな編集強度での一致を、独立した予測精度の証拠として数えてはいけない。
編集強度1は、Astraが使ったゲイン6に相当する。原著のタスクで効果を上げた強さまで編集すると、局所Fisherモデルの精度は保たれなかった。つまり、タスクの改善は局所近似の正しさを裏付けるものではない。局所近似が有効な範囲を外れても、編集はタスクを改善しうる。計量が記述するのは近傍での変化であり、生成の全過程ではない。
さらに、ここで測っているのは、固定したprefixから予測する次トークンの分布である。実際の生成では、介入によって次のトークンが変われば、それ以降のprefixもFisher行列も変わる。系列全体を論じるには、系列の確率分布と介入の経路を定義しなければならない。固定prefixでの結果を、そのまま生成全体へ広げることはできない。本プロジェクトの理論ノートでも両者を区別しており、有限の長さを持つ生成軌道に対する保証は未解決の拡張としている。
局所KL実験の測定条件
KLは、固定prefixに対する通常のsoftmax分布をFP32で計算した。生成時のtop-k・top-pサンプリングによる分布の切り詰めは含めていない。有限差分の基本ステップ幅は0.001とし、0.003と0.01でも導関数の推定を点検した。調べたのは、保存された一つの編集方向だけである。
活性化ノルムを使う比較手法には、介入後の実行で得られる活性化を用いている。したがって、未編集の状態だけから使える予測ではない。また、この実験は、あるFisher推定を別の方向や別のprefixに転用しても予測できることを示してはいない。
5. 一つの行列でどこまで動かせるのか——計量を変えると何が変わるのか?英語原文 ↗
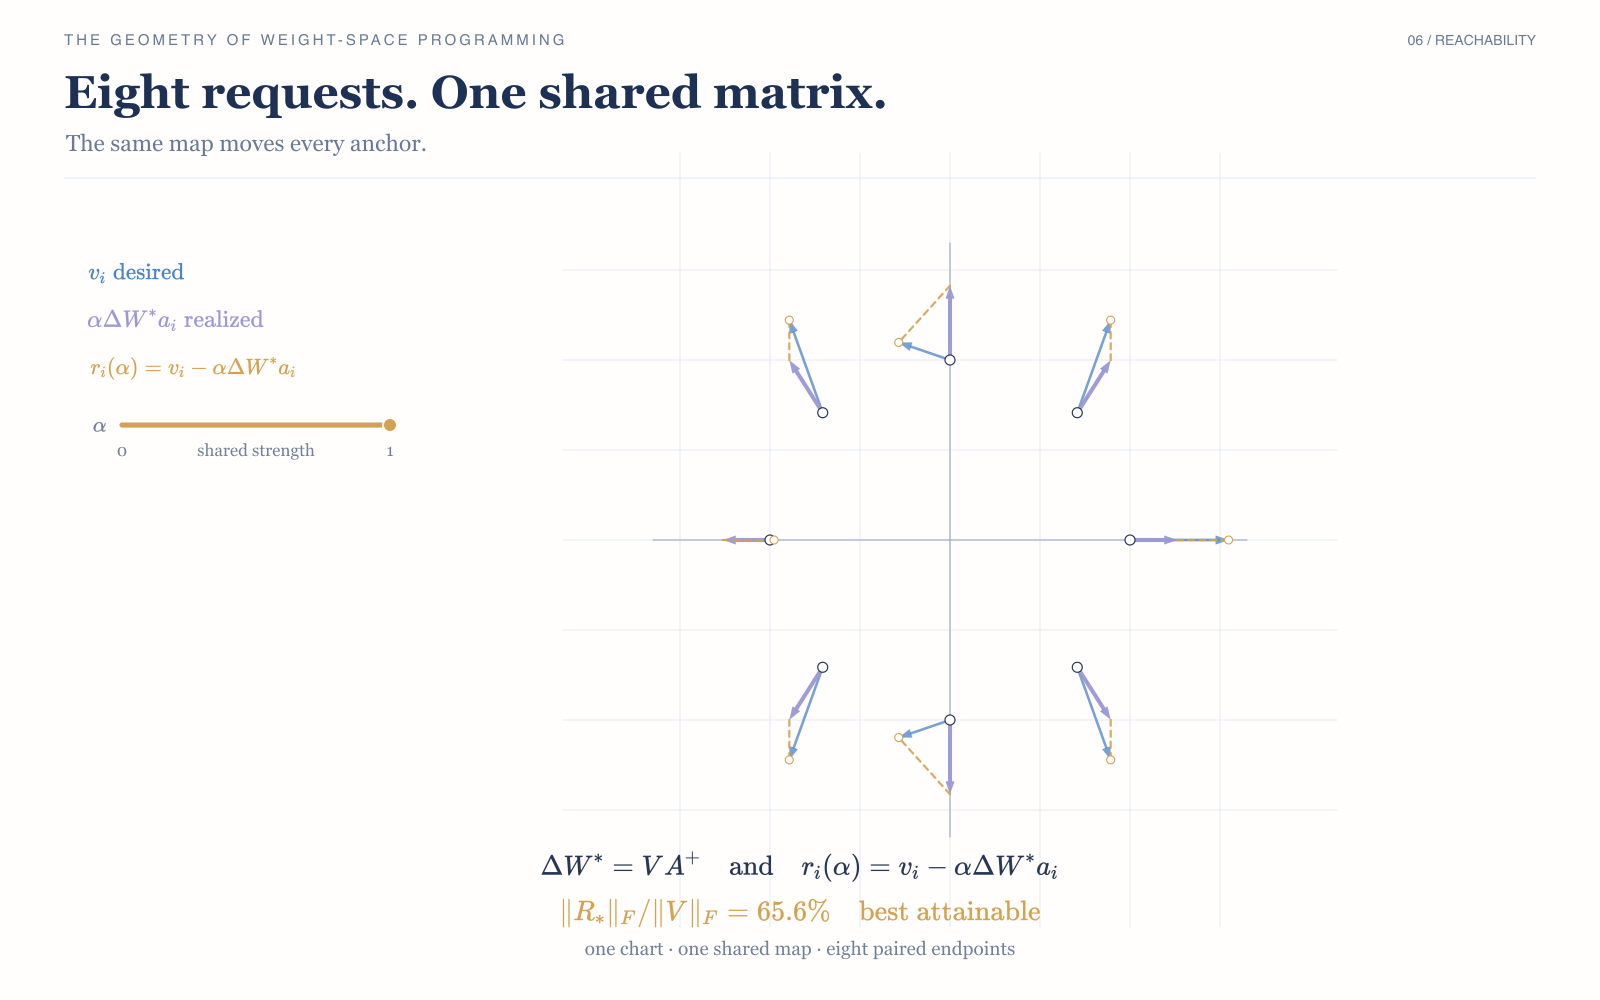
8個の入力への要求を、一つの行列で満たそうとする。この数学例では最もよく当てはめても残差が残る。共有行列では、各入力を独立に動かせないためだ。
大きく表示 ↗
この図では、要求する変化と実現できる変化を、一つの座標図に重ねている。8個の入力のそれぞれで、青い矢印は要求する変化、紫の矢印は共有行列が生む変化を示す。紫の矢印はすべて同じ行列で決まるため、一本ずつ自由に調整することはできない。金色の線分は二つの端点を結び、その行列では満たせない要求の残りを示している。
8入力の単純例と最小二乗診断
8個の入力を行列 の各列に、求める活性化の変位を の各列に並べる。一つの2×2行列の更新で、これらすべてに同時に近づけなければならない。ずれをユークリッド計量 で測ると、最小二乗解は
となる。アニメーションでは、更新行列をゼロからこの解まで徐々に変えている。そのため、実現される8本の矢印も一緒に動く。金色の線分は、それぞれの矢印の到達点と、要求された到達点を結んでいる。最適な解を選んでも、残差のフロベニウスノルムは、要求した変位の場のノルムの65.6%に相当する。
この値は、説明のために構成した例について計算したもので、Qwenの測定値ではない。動きも、あらかじめ求めた解に向けた補間であり、Astraの探索や最適化アルゴリズムの実行記録ではない。
入力、要求した変位、解、残差はモデルファイルに記録している。正規方程式が満たされるかを調べる量 は約 となった。残差は残るものの、実現可能な変位の場には直交している。では、距離の物差しをユークリッド計量から変えたら、どの解が「最も近い」のだろうか。
どの変化が「最も近い」のか?
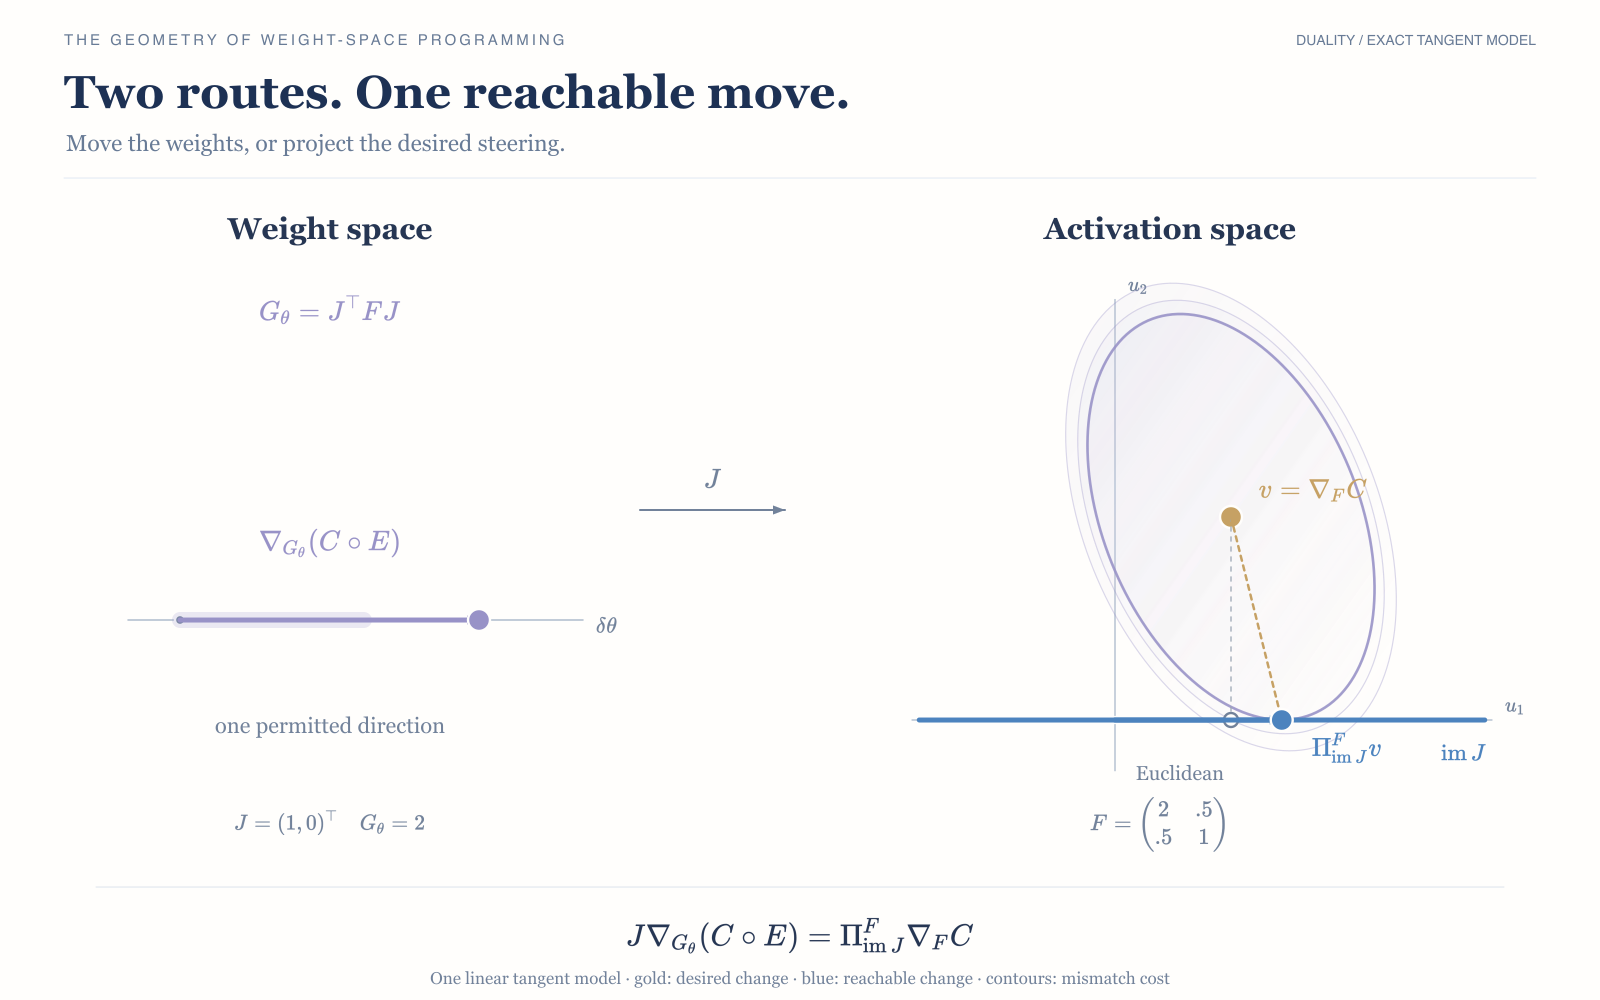
重みを自然勾配に沿って動かす。あるいは活性化側の自然勾配を、実現できる変化へ射影する。完全な介入インターフェースと引き戻したFisher計量のもとでは、局所的に同じ結果になる。
大きく表示 ↗
右の図には、望む活性化の変化と、編集を許された重みで実現できる変化の直線を描いている。楕円は、望む変化からのずれを測る等コスト線だ。楕円を縮めて直線に接したところが、Fisher計量で最も近い実現可能な変化になる。灰色の白抜き点は、それとは異なるユークリッド射影を示す。左では、重み空間の自然勾配に沿った一歩が、同じ実現可能な変化へ写る。同期した二本の矢印が、異なる経路から同じ結果に到達することを示している。
実装で問いたいのは、一つの共有行列でどこまで要求に応えられ、その中でどの変化を選ぶか、ということだ。図は実現可能な範囲を示す。条件を満たすと、この選び方は次の式で結び付く。
ここで扱うのは、重み編集と活性化の場を結ぶ随伴と計量の関係である。編集可能な重みの座標 から、介入する箇所の状態への写像を とし、その微分を とする。状態には、多数の入力に対する活性化をまとめて並べてもよい。ただし、それ以降の計算を固定したうえで、重み編集の影響を漏れなく受け渡せる状態を選ぶ必要がある。これが「完全な介入インターフェース」という条件である。
活性化空間の計量 を によって重み空間へ引き戻すと、 を得る。
自然勾配は、選んだ計量で距離を測りながら、目的関数を変える方向を求める。本稿では、勾配記号の下に使う計量を添える。次の式は、実現可能な変化を選ぶ二つの手順が一致することを表す。
識別可能な座標を使うか、後述するように零方向を除いた商空間で考えると、滑らかな目的関数 に対して、次の恒等式が成り立つ。 左辺は、重みを自然勾配の方向へ動かしたときに生じる、活性化の変化を表す。右辺は、活性化空間での自然勾配を、重み編集で実現できる範囲へ射影したものだ。この射影にもFisher計量を使う。重み側で自然勾配を求めてから活性化へ写しても、活性化側で自然勾配を求めて実現可能な範囲へ射影しても、局所的には同じ変化になる。
計量勾配の定義と共有入力に対する計量
どの計量で勾配を定めるかを明示するため、計量勾配演算子 を使う。これは、スカラー目的関数の微分を、計量 を用いて方向ベクトルに変換する演算子である。正定値の と任意の接ベクトル に対して、次を満たす。 は、方向 へ動いたときの の一次変化を表す。 は、通常の座標微分を並べた列ベクトルである。 なら通常のユークリッド勾配になり、Fisher計量を使えば自然勾配になる。下付き添字は微分する方向ではなく、使う計量を指定している。ベクトル場の共変微分とは異なり、逆計量によって微分の添字を上げる操作である。
一つの書き込み行列については、 となり、引き戻した計量を入力について平均すると となる。この平均に含まれるすべての入力で、同じパラメータ更新を使う。重みを共有する以上、ある入力へのステアリングを、他の入力への作用と無関係には決められない。
射影恒等式:証明と条件
微分幾何の添字記法では、 ここで は逆計量を表し、同じ添字が繰り返される場合は総和を取る。スカラーの共変微分は であり、添字を上げると勾配ベクトルになる。ここでの下付き は計量のラベルであるのに対し、 の添字 は座標方向を示す。
は識別可能な活性化座標上で正定値とする。微分 の座標表示を と置く。 が特異なら、勾配は による商空間上で解釈する。選んだ重み座標でユークリッドノルムが最小となるムーア・ペンローズ代表元を使うと、次式を得る。 一方、-直交射影は である。これを に適用すると、同じ式が得られる。
Fisher計量自体が特異な場合も、識別可能な商空間で考える。このとき、目的関数の微分は零方向に対してゼロでなければならない。単にユークリッド座標での擬似逆行列に置き換えるだけでは、座標に依存しない定理にはならない。
介入箇所以降の写像は固定しておく必要がある。複数箇所に介入するなら、完全なインターフェースを選ぶか、介入グラフを明示して、箇所どうしの依存関係を含める。この恒等式が述べるのは局所的な一致であり、有限の大きさのステップで最適化を進めた軌跡まで一致するわけではない。
甘利の双対性とベクトル・共ベクトルの区別
もう一つは、出力を指数型分布族で表すときに現れる、甘利の自然座標と期待座標の双対性である。ソフトマックスの自然座標を 、十分統計量の期待値を とすると、
が成り立つ。期待座標での直線運動は、自然座標では一般に曲線として現れ、その逆も同様である。これが出力表現における「双対ステアリング」の数学的な基礎となる。ただし、重みそのものが期待座標であるとか、すべての隠れ層が双対平坦である、という意味ではない。中間計算の非線形性、ランク欠損、識別できない方向については、それぞれ条件を確かめる必要がある。
これらの関係を使えば、Qwenの編集を数理的に捉えられる。ランク1の書き込みが入力に応じて強さを変える仕組みや、局所的な目標効果を揃えたまま、Fisher計量を考慮して出力KLを下げられる可能性を説明できる。一方、対比に使う例をAstraがどう選んだのか、なぜ層15と19が有望だったのか、なぜゲイン6を試したのかは説明できない。ログから読み取れるのは、観測に応じて試みを変える探索過程であって、Fisherを計算して選択したという事実ではない。
ここで、ベクトルと共ベクトルを混同しないようにしたい。二種類のテキストの活性化差は、表現がどちらへ変わったかを示す変位ベクトルである。一方、モデルの挙動に関する目的関数の微分は、小さな変位に対して目的がどれだけ変わるかを測る共ベクトルである。両者の役割は異なる。Fisher計量による対応を使うには、計量と局所的な出力モデルを定めなければならない。
したがって、対比から得たベクトルを機械的に へ置き換えても、自然勾配に基づくステアリングになるわけではない。それでは数学的に異なる対象を取り違えている。提案中のE5では、目的関数、コストを測る位置、減衰、効果を揃える手順を事前に定めている。その条件のもとで候補方向を考えるのであって、有用な方向なら何でもFisherで前処理すべきだと主張しているわけではない。
「ステアリングを重みにコンパイルする」という表現も、同じ制約のもとで理解すべきである。ここでのコンパイルとは、編集可能な行列を使って、ある入力集合に対する活性化の変化を実現することだ。入力に依存しないプログラムが得られるわけでも、任意の変化を実装できるわけでも、他の機能がすべて保たれるわけでもない。一つの行列を共有するため、異なる文脈への作用も結び付く。成功した編集も、制約された関数の集合から選ばれた一つであり、副作用を含めてそのプログラムの働きと捉える必要がある。
編集を設計するなら、まず、許された重みでどの要求を満たせるかを調べる。次に、保ちたい出力への影響をコストとして、その範囲内で候補を比べる。計量は候補を選ぶ手がかりになるが、実際の生成で役に立つかは別に検証しなければならない。
同じ効果を、より低いコストで実現できるか?
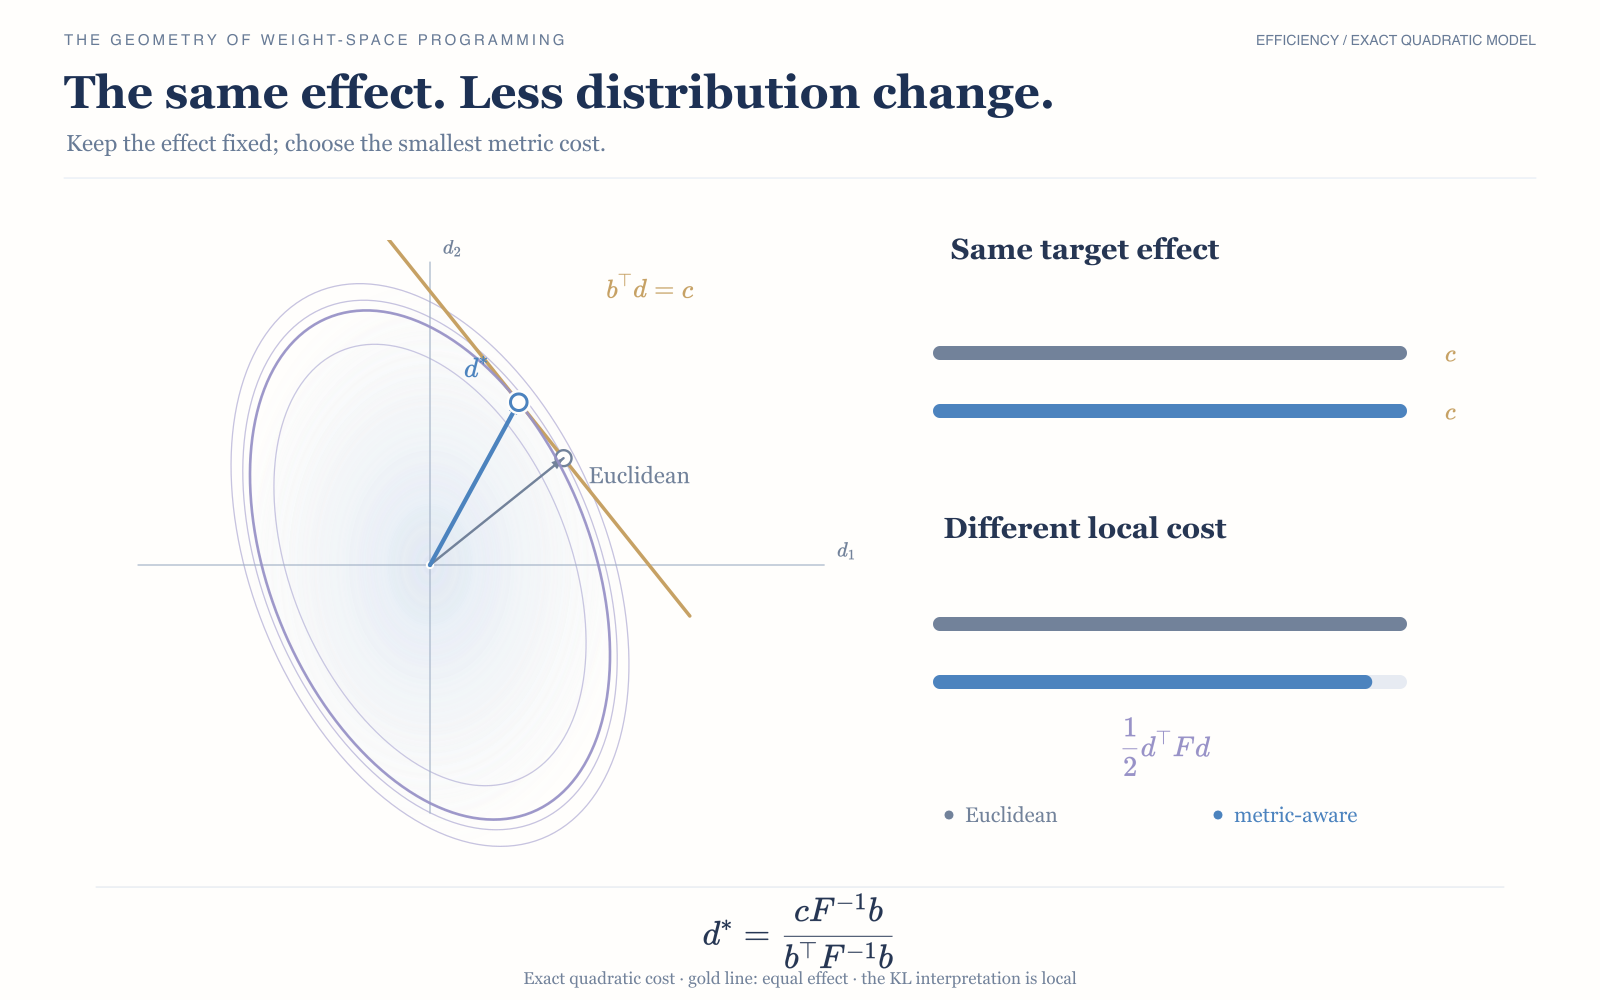
一次近似での目標効果を揃え、二次コストが最も小さい変化を選ぶ。このモデルでは幾何から最適な候補が求まるが、Qwenの編集が改善したという実験結果ではない。
大きく表示 ↗
この図の金色の直線上では、どの点を選んでも、一次近似で同じ目標効果が得られる。楕円は、保ちたい出力分布を変えてしまうコストを二次形式で表した等高線だ。直線に接する最小の楕円へ向かえば、目標効果を揃えたままコストを下げられる。青い点が、その最小コストの変化に当たる。右の棒は、効果を一定に保ちながらコストだけが下がる様子を同期して示す。
計量 を正定値とし、目的関数のゼロでない微分を 、目標効果を とすると、この最適な変位は次式で与えられる。
図に用いたのは、明示的に定義した2次元の二次モデルである。点はAstraの編集を測定した値ではなく、同じ効果を持つ候補を表す。アニメーションも、その候補をたどる説明用の動きであり、探索の記録ではない。
実際の編集に使うには、計量を推定し、目標効果を揃えたうえで、探索に使わなかったデータで挙動を評価する必要がある。情報幾何の役割は、こうして検証すべき方向と比較方法を提示することにある。この説明によって、Astraが過去に行った探索を自然勾配法だったと解釈できるわけではない。
効果を揃えたときの最小コスト
制約 のもとで を最小化する。停留条件から を得て、制約を代入すると上の解が求まる。同じ制約を満たす別の点を と書けば、 なので、
となる。二次形式については厳密に成り立つが、これをKLのコストと読むときは局所近似である。計量は、活性化の座標でも、編集可能な重みの座標でも定義できる。両者は引き戻し で結ばれるが、先に述べたランクと零方向の条件が必要となる。
6. 重みを共有すると、なぜ実現できないステアリングが生まれるのか?英語原文 ↗
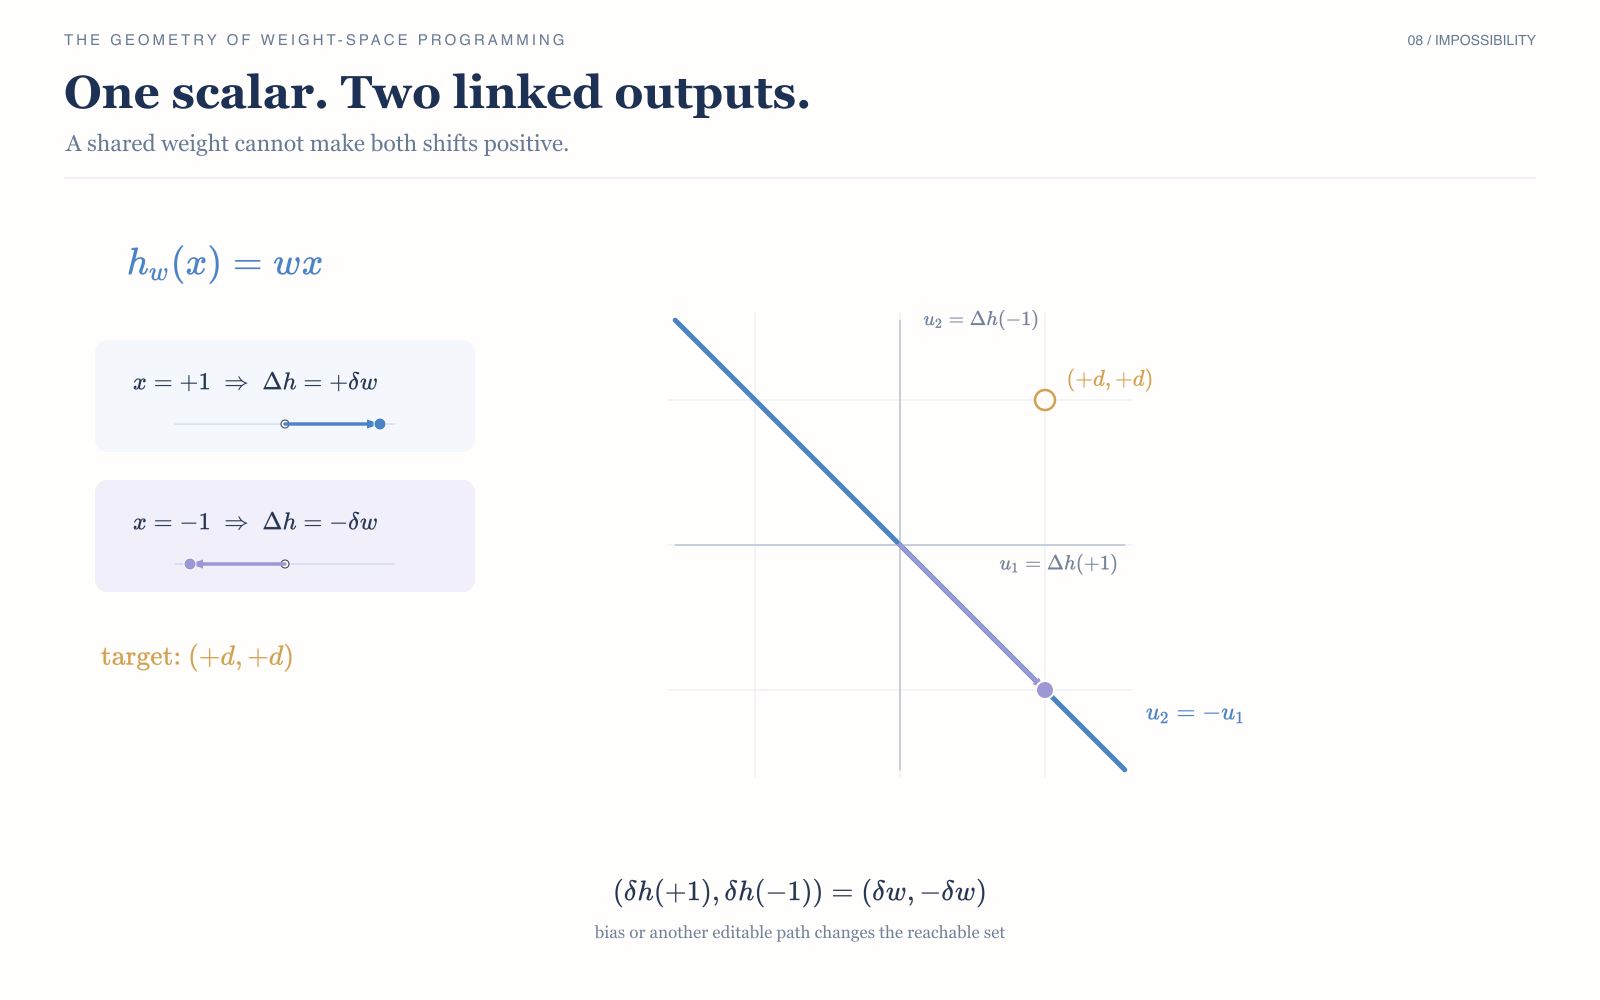
一つの重みを変えると、二つの入力は逆向きに動く。両方を正の方向へ動かすことはできない。この厳密な反例はバイアスなしの線形モデルであり、バイアスも編集できれば事情は変わる。
大きく表示 ↗
最も簡単な例で考えよう。重みが一つだけのモデル に、 と を入力する。重みを だけ変えると、活性化の変化はそれぞれ と になり、必ず逆向きになる。
では、両方を同じ正の量 だけ動かしたいとしたらどうか。活性化への直接介入なら を加えられる。しかし、共有重みの編集では と を同時に満たさなければならず、 なら不可能である。
この小さな例だけでも、共有重みによる制約が見える。重み編集では、入力ごとのステアリングを独立には指定できない。一つのパラメータ変更によって、複数の入力への作用が結び付いているからだ。一般に、局所線形化において、編集可能な重みの変位から活性化の変位への写像を とする。この線形化モデルで実現できるのは に含まれる変位だけである。重み側の資源コストを測る正定値計量を とすれば、実現可能な変位 を生む最小コストは、次のように書ける。
要求が の外にあれば、制約を満たす編集は存在せず、コストは となる。右辺の擬似逆行列の式だけを使い、実現できない要求にも有限のコストを割り当ててはいけない。これらの実現可能性とコストの主張は、線形なインターフェースでは厳密に成り立つ。一方、非線形モデルでは、線形化した要求を満たせないことだけから、有限の編集も不可能とは結論できない。双対変数を使えば、線形化モデルにおける実現不可能性を示せる。これは実装上の判断にも役立つ。バイアスを加える、別の層を編集する、保護したい文脈への制約を緩める、あるいは探索を打ち切る、といった選択の根拠になる。
また、Fisher計量だけでは、編集箇所の少ない解を選べない。異なる重み変更が同じ局所的な活性化の変化を生めば、出力Fisherコストも同じになりうる。64列、二つの層、あるいは特定の疎なマスクを選ぶには、別途、資源制約、アーキテクチャに関する事前分布、探索の規則などが必要になる。Astraが選んだマスクは、成功したプログラムの一部として観測されたものであり、計量から一意に導かれたものではない。
7. 甘利の双対性はどこに現れるのか?英語原文 ↗
ここで、もう一つの双対性である自然座標と期待座標の関係を、図で確かめよう。
3クラスのsoftmaxを考え、冗長性を除くため、第三のロジットをゼロに固定する。残る二つを自然座標 とし、次を定義する。 期待座標は確率そのものを表し、自然座標は対数オッズ を表す。座標が違うだけで、表している分布は同じである。 のヘッセ行列がFisher行列になることから、 が成り立つ。期待座標で一定の速度を保って進むには、自然座標では一般に速度を変えなければならない。アニメーションは、同じ確率分布の変化を、二つの座標系で同時に描いている。
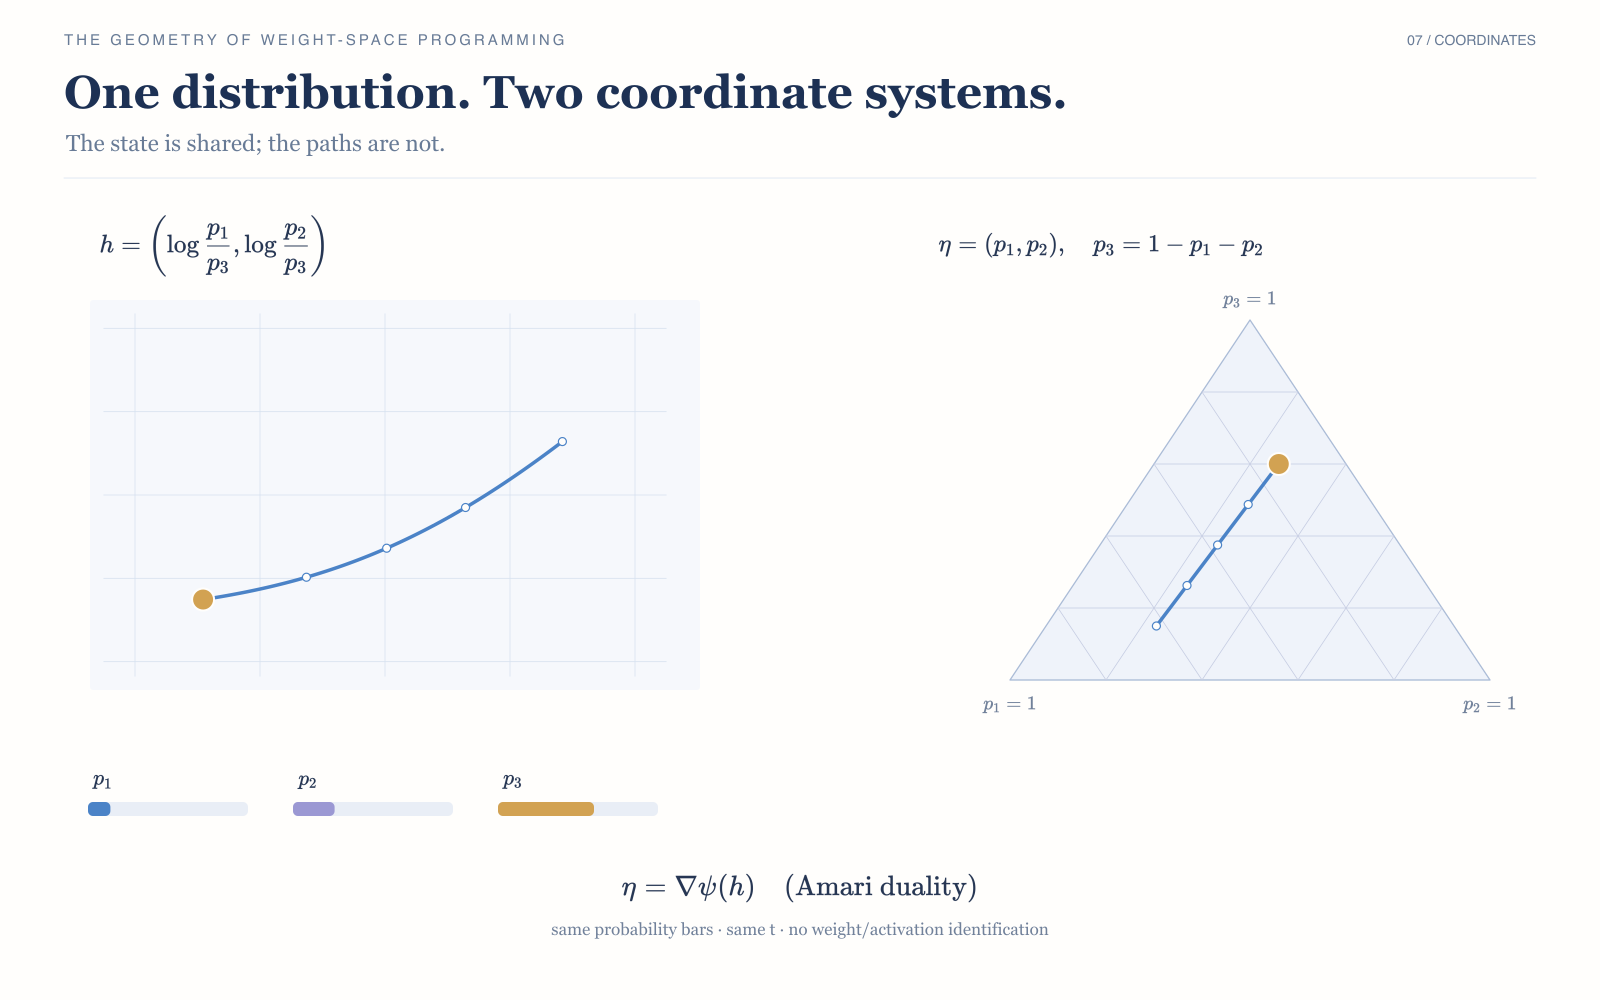
確率の座標での直線は、対数オッズの座標では一般に曲線になる。左右は同じ分布の変化を表す。このsoftmaxの双対座標と、重み・活性化の対応は別の関係である。
大きく表示 ↗
この図は、座標変換を解析的に計算したものであり、Qwenの内部を測定して得た地形ではない。一方は対数オッズの空間、もう一方は確率単体である。棒グラフを同期させることで、見かけの異なる二つの経路が、同じ確率を表していると分かる。確率単体の内部では、双対ポテンシャルは負のエントロピー となる。
この自然座標と期待座標の双対性は、重みから活性化への射影恒等式とは区別しなければならない。重みと隠れ層の活性化が、そのまま互いのルジャンドル双対座標になるわけではない。 任意の中間層を、最小指数型分布族や双対平坦な空間として扱えるとは限らないからである。
出力の計量を隠れ層へ引き戻すことはできる。しかし、それだけで、隠れ層全体にも大域的な双対平坦構造が受け継がれるとは言えない。
それでも、モデルの挙動について目的関数を定めれば、幾何から具体的な編集候補を導ける。共ベクトル が目標とする一次変化を測り、 が有用な出力を保ちたい文脈でのコストを測るとする。このとき、減衰を加えた候補方向は に比例する。この方向が有用かどうかは、目標効果を揃えて検証する必要がある。現時点では研究上の提案であり、Astraの編集を上回ると実証された方法ではない。
8. この結果から、何を目指せるだろうか?英語原文 ↗
Astraは、Qwenの内部で動く小さなプログラムを見つけた。 その編集は、現在の活性化を読み取り、残差ストリームへの書き込み方を変える。公開ログからは、繰り返す失敗を手がかりに、活性化の対照、介入、ゲインを変えた評価を重ね、探索に使わなかった問題での改善へたどり着いた過程を追える。
本稿の貢献は、このプログラムを再構成し、次の編集を考えるための道具へつなげた点にある。厳密な線形の恒等式が、重みの変更と活性化への介入を結ぶ。共有重みの制約からは、異なる入力への補正を同時に実現できるかが分かる。Fisherは、出力分布への局所的な影響を測る物差しになる。これらを組み合わせれば、補正を試し、編集を許された重みに保存できるかを調べ、残したい振る舞いへの影響を比較できる。
私たちのE1では、編集を加法的介入として再構成し、FP32での数値的一致を確認した。E3では、固定prefixに対する小さなKL変化をFisher幾何がよく予測する一方、元のゲイン6の強さでは予測が外れた。これは近似が通用する範囲を示す結果であり、原著が報告した課題で編集によって成績が改善したという結果は残る。E2では人工的な系列への応答を調べた。自然な生成で生じた反復ではなく、対照条件との効果も揃っていないため、生成中にスイッチが必要かどうかまでは判断できない。
次の実験には、以下の手順を提案したい。今回実施した確認と、これから行う比較を組み合わせたものだ。
| 判断 | 次に行うこと | 確かめたいこと |
|---|---|---|
| 失敗の共通点を探す | 重みを編集する前に、回答の完了、反復、打ち切りと、内部表現の違いを測る。 | 共通する障害を、測定と介入の対象にできるか。 |
| 活性化への介入を試す | MLPダウンプロジェクションで候補となる補正を加え、状態による応答の違いを調べる。 | 提案したランク1の規則を数値的に再現できるか。 |
| 対照条件と比べる | 定数、シャッフル、ランダムの各対照条件で目標への効果を揃えてから、他の出力への影響を比べる。 | 同じ効果で比べても、期待した利点が残るか。 |
| 介入の強さを選ぶ | 弱い介入から、元の編集と同じ強さまで変えて測る。 | 局所計量が予測に使える範囲はどこまでか。 |
| 共有重みの制約を調べる | 複数の入力への要求を同時に満たす編集を求め、残差と実現可能性を確認する。 | 一つの共有行列で、求めるステアリングを表せるか。 |
| 生成時の効果を確かめる | 探索に使わなかった問題で実際に生成させ、サンプル数を揃えて挙動と成績を評価する。 | 固定prefixやteacher forcingで得た結果が、生成にも当てはまるか。 |
一度うまく働いた補正を、繰り返し使える技術へ
この代数は、編集できる線形写像がモデルの活性化へ書き込む箇所に共通して成り立つ。有効な方向やゲート、介入箇所は異なっても、モデルを越えて同じ設計上の問いを立てられる。有効なステアリングの規則を見つけ、共有重みで実現できる部分を調べ、保存した規則を新しい入力で試す。 独立したWSPの追試研究も、複数の課題での改善を報告している。一方で、他の課題への効果にはばらつきがあり、元のモデルを維持した探索もあった。次に目指したいのは、有効な編集を安定して発見できる手法だ。
この問いは、モデルの振る舞いを制御する最近の研究とも直接つながる。AnthropicのAssistant Axisは、活性化に制約を加えて振る舞いを安定させる。Goodfireのmanifold steeringは、表現の幾何に沿う介入を調べている。本稿が加える問いは、そうした有効な介入のうち、どれを共有重みの編集として実現できるか、である。射影の恒等式は、この問いを局所的に厳密な形で表す。求める補正が実現可能な空間の外にあれば、編集の形式を変えるか、活性化への介入を使い続けるかを判断する手がかりになる。
幾何の実用上の価値を確かめるには、改善したい挙動を元の目標に固定し、より単純な編集の選び方との比較を事前登録したい。狙った改善効果と、計量の推定費用を含む総予算を揃え、探索に使わなかった課題で振る舞いを比べる。人工的な対照に加えて、自然に生成された軌跡も使い、探索用と評価用のデータを分ける。介入の大きさを保ち、想定した仕組みだけを崩す対照も置けば、補正が働く理由を調べやすくなる。
知りたいのは、大規模な生成に計算資源を投じる前に、残したい振る舞いへの影響が少ない編集を、計量から予測できるかだ。この実験で、編集を選ぶ道具としての幾何の有用性を確かめる。原著のログにはすでに、LLMが観測、内部の測定、繰り返しの検証を通じて、小さな規則を見つけた実例がある。
一度の改善が、次の改善を生むとしたら?
面白いのは、編集によって、モデルが次の改善を見つける力まで高まる可能性だ。 既存の能力をより確実に発揮できるよう修正すれば、より良い編集の提案や評価にも役立つかもしれない。今回の事例では、編集者がAstra、編集対象がQwenだった。編集を作る能力そのものが高まるか、その改善が複数の段階にわたって続くかを、これから実験したい。
まず、編集対象のモデルを同じチェックポイントに固定し、編集前後のモデルを編集者として比較する。道具、与える情報、フィードバック、計算予算を揃える。次に、編集者自身を更新する条件と、編集者を固定した条件を、蓄積した情報と総予算を揃えて比べる。再帰的に改善する条件では、採用した編集後のモデルが次の段階の編集を担う。編集を採用するたびに、活性化と局所計量を測り直す。
編集の採否を決める評価と、最後まで使わない最終評価は分ける。成功だけでなく失敗した探索も数え、各段階を独立に評価する。これにより、編集者を改善すると次の編集も良くなるか、その効果が持続するかを調べられる。Astra–Qwenの実行は、その出発点であり、この循環を実証したものではない。
この問いは、AIによる研究自動化へもつながる。OpenAIの研究加速に関する報告やMETRによるAnthropicの評価は、AIがその後のモデル開発にどう寄与するかを調べている。WSPは、その作用を詳しく調べられる操作を与える。モデルが重みの変更を提案し、その変更が何をするかを調べ、独立した評価で採用を決める。本稿の提案は、幾何を使ってこうした操作の設計と検証を助け、さらに、モデルがその手順自体をより上手く行えるようになるかを調べることだ。
分析の範囲、未解決の問い、先行研究との関係
ここで詳しく調べた「一つのモデルの一つの失敗」とは、本稿で分析したAstra–Qwenの事例を指す。原著のWSP研究が扱った実験全体の範囲を指すものではない。また、この事例だけからWSP全般のスケーリングは判断できない。AstraがFisher幾何を使ったという証拠はない。ゲートを備えたランク1の規則が、一般に見つけやすいとも示されていない。新しい能力を加えたのか、もともとの能力の発揮を妨げる障害を取り除いたのかも、確定していない。
情報幾何は、実験を組み、実現できない要求を見分けるための道具になる。しかし、失敗の診断や振る舞いの検証を代替するものではない。線形の恒等式が一般的に成り立つことで、条件を満たすモデルの介入箇所を共通の数理で扱える。有効な編集を異なるモデル系列でも安定して見つけられるか、複数の段階にわたって改善が続くかは、実験で確かめる問いである。
これらの関係には、甘利の自然勾配、Steer2Edit、FishBackなどの先行研究がある。本稿は、一つのWSP事例について、説明できる範囲と限界を確かめたものであり、双対性そのものの新規性を主張していない。貢献は、公開されたプログラム、数値的な再構成、局所幾何、今後の編集を検証する手順を結び付けた点にある。
Astraの編集は、仕組みを調べ、実行し、効果を確かめられる有効な規則を与えてくれた。その理解を、モデルを越えて安定して使える手法へ育て、一度の改善が、次の改善を見つける力まで高めるかを試す。 モデルの制御から再帰的自己改善へ進むための、具体的な研究目標である。
付録:LoRA,モデルの構築,Model Mapへどうつながるか?英語原文 ↗
Qwenの事例から得られたのは,内部で何をするかを調べられる編集規則だ。この分析を先へ進めるために,三つの接点を考えたい。LoRAで学習した更新も同じように読めるのか。重みからネットワークの機能を読み取り,あるいはネットワークを構築するには何が要るのか。そして,モデルが文章に与える確率から,編集の効果を測れるのか。それぞれが説明する範囲は異なる。編集の実行を表す代数はそのまま使えるが,編集を見つけ,計算構造を作る過程には,さらに説明が必要になる。
A.LoRAもsteeringの規則を重みに格納するのか?
そう解釈できる。線形層に入る活性をとすると,ランクrのLoRA更新は次のように書ける。
行列Aが現在の活性から少数の値を読み取り,Bがそれに応じた補正を書き込む。更新された重みには規則が格納され,入力される活性によって,その規則の働き方が決まる。本文のランク1の編集は,この特別な場合に当たる。これはLoRA原論文の§4.1に記された順伝播の計算であり,本稿で新たに発見した恒等式ではない。
違いは,規則をどう見つけるかにある。通常のLoRAは,勾配による最適化で二つの行列を学習する。今回のQwenの事例では,Astraが失敗の観測,内部の測定,フィードバックを通じて簡潔な更新則を組み立てた。その編集は,丸めを除いた理想的な形では低ランクで表せる。ただし,WSPには低ランクに限らない操作も含まれる。また,勾配を使わないことと,データを使わないことは異なる。 原著の実験設定にあるように,Qwenの編集では練習問題や評価ツールが与えられていた。
この見方から,具体的な比較ができる。LoRAで学習した更新とAstraが見いだした編集を,ともに活性に働く規則として調べる。どの入力で補正が起こるか,その向きがどう変わるか,残したい出力にどんな影響が及ぶかを比べられる。幾何を使えばより良い規則を選べるかは,今後の実験で確かめる問いだ。
厳密な実行の対応,複数層の編集,有限精度
二つの行列の次元は,で,スケール係数はである。同じ活性を受け取る線形射影では,上の恒等式は実数演算として厳密に成り立ち,更新が微小である必要はない。複数の層を編集する場合,後段のhookは,先行する介入の影響を受けた活性を読み取らなければならない。未編集の実行から計算した固定ベクトルでは,一般に同じ計算を再現できない。
公開されたQwenの操作は,各編集層で,列を選択したランク1の形に理想化できる。ただし,保存時の丸めによって,ランク1ではない残差が加わり得る。保存されたモデルを再現するには,実際に保存された差分を使う必要がある。それでも,重みを統合した実行とhookによる実行がビット単位で一致するとは限らない。実行の厳密な対応と,小さな変化に対するFisher近似は,別の主張である。局所的な範囲が必要なのは後者だ。
B.重みから機能を読み取り,ネットワークを作る過程も説明できるか?
情報幾何を使うには,まずモデルの出力をどのような確率分布として扱い,どの入力や状態で評価するかを定める。そこで初めて,重みと振る舞いの対応を調べられる。構築したモデルが何をするかを確かめるのに役立つが,編集者がその構造をどう見つけたかという問いは別に残る。
重みからのモデル分類では,学習タスクなど,ネットワークの性質を当てることが目標になる。分類する側は,機能を表す構造を読んでいるかもしれないし,初期化や学習過程の痕跡を利用しているかもしれない。出力を保ったままニューロンを並べ替えても分類できるかは,一つの確かめ方になる。座標の配置だけを変えたときに判断が保たれるかを見れば,説明を切り分ける助けになる。ただし,この検査だけですべてを判断できるわけではない。
スクラッチからの構築について,原著のMinAtar実験では,ゲームの規則,ソースコード,ネットワークの入出力仕様が与えられ,Astraが小規模な方策ネットワークを書き上げた。これは,手続きを重みとして実装した具体例である。出力分布を定めれば,できあがった方策の周囲の変化をFisher幾何で測れる。一方,その手続きをどう組み立てたかの説明には,ネットワーク構造の知識やプログラム合成の視点も必要になる。先へ進む道筋は,構築と振る舞いの測定を結ぶことだ。 候補を作り,内部で実行される計算を読み,その後の編集が何を変えるかを評価する。
確率分布として何を定める必要があるか
行動を決定的に一つ選ぶだけでは,滑らかな確率モデルは定まらない。行動のスコアをsoftmaxで確率に変換するなら,温度と,評価に使う状態の分布を明示する必要がある。どちらも計量に影響する。同様に,中間層の重みの一部だけでは,ネットワーク全体の出力分布が定まるとは限らない。また,分布間の距離が分かるだけで,学習タスクのラベルを復元できるわけではない。これらには追加のモデル化や推論が必要であり,計量の引き戻しの恒等式から自動的に得られるものではない。
C.Model Mapで,編集によるモデルの移動を見られるか?
Model Mapは,同じ文章の集合を,各モデルがどれくらい尤もらしいと評価するかを調べ,その対数尤度から座標を作る。論文では,この座標とKL divergence,Fisher幾何の局所的な関係がすでに導かれている。本稿はその関係を出発点として用いるもので,関係そのものの新規性を主張していない。Model Mapの§2.4とAppendix Dを参照されたい。
N個の文章で評価したモデルiについて,論文の二重中心化を施した対数尤度ベクトルをとする。モデルが共通の参照分布に近く,コーパスがその分布から得られている条件の下で,論文は次の近似を導いている。
ここから,小さな重み編集との接続が見えてくる。上の近似条件が成り立ち,一貫して同じ出力分布を対象とするなら,
と書ける。Fisherは小さな移動を重みの側から予測し,Model Mapは対数尤度の変化を通じて測る。 本文の活性の解析は,その間にある介入を説明する。構造の異なるモデルでも,共通の文章に与える確率から比較できるので,次元や意味の異なる重みベクトルを直接引き算する必要はない。
次の実験として,WSPとLoRAの編集強度を変え,同じ対数尤度の座標上で移動を測り,Fisherの予測と比較することが考えられる。探索に使っていない課題での性能や,残したい振る舞いは,別途評価する必要がある。距離が測るのは変化の大きさであり,改善の良し悪しではない。Model Map論文の§6.3でも重みの補間を調べているが,ここで提案する実験は,個々の編集規則とその局所的な効果を対象にする。
導出,標本の条件,活性の幾何との接続
固定したコーパス上の対数尤度ベクトルを,編集を許す重みに関するそのヤコビアンをとする。N個の文章にわたる中心化をで表す。モデル間の中心化で引く原点は,微分するときには固定する。二つのモデルの差を取れば,この共通の原点は打ち消される。このとき,
ノルムを二乗すると,
となる。これはスコアの標本共分散である。分布から独立に標本を得る場合,その分布の下でのスコア共分散を推定する。通常の正則条件の下で,なら,モデルのFisher行列に収束する。任意の固定コーパスでこの一致が保証されるわけではない。Model Mapの近似は,モデルがコーパスを生成した分布に近いことを用いる。ここでの接続はTaylor展開によるもので,新たな実験結果ではない。
活性へつなぐため,ここからはxを評価する文脈とする。許された編集の効果がすべて選んだ活性インターフェースを通り,その先の計算は固定されていると仮定する。とすると,条件付き出力分布のFisher計量は次のように引き戻される。
ここで,は微分としての変位である。一つの共有された編集が複数の文脈に作用するため,期待値を取ることが重要になる。系列全体の分布を扱う場合には,対応する条件付きの項をトークン位置にわたって足し合わせ,基準モデルが生成する履歴の分布で平均する必要がある。任意の固定prefixを使う場合には,その文脈で重み付けされた計量になる。
本稿のE3は,固定prefixでの次トークン分布を測定している。一方,Model Mapの基本形は文章全体の尤度を使う。確率の対象と標本の条件を揃えなければ,両者の数値を同一視できない。また,上の距離は元の高次元座標で測るものであり,二次元のPCA表示では重要な方向が失われることがある。
これらの接続によって,次の実験を具体化できる。補正を見つけ,実行される規則を調べ,振る舞いの変化を測る。同じ探索手順や同じ座標がどのモデルでも同様に役立つと仮定せずに,異なる編集の作り方を比較するための足場になる。
参考資料
関連する一次資料と本プロジェクトの文書: Astra最終レポート、本稿の英語版、活性化の情報幾何ノート、E5 v2計画。
本稿の寓意画はFigma AIで生成し、Figma Design上で編集可能な図版に組み上げた。BetaTomorrow / deep Manifold の、水彩による科学の表現、半透明の面を重ねる構成、理解を助ける注釈から着想を得ている。図版は本稿独自の制作物であり、同アカウントによる制作や推薦を示すものではない。
-
原典のWeight-Space ProgrammingレポートとREADME。報告された7.9%、48.1%、93.0%、33.1%の値は、
blog/data/measurements.jsonにも記録している。 ↩↩ -
Astraの最終レポート。初期の診断と、探索に使わなかった練習問題での確認を含む。 ↩
-
完了した予備実験の概要。生成サンプル数は条件間で異なる。 ↩